脱力系ぷかぷかドイツ日記

脱力系ゆるふわドイツ暮らし

ヘッセン州の田舎町でデジカメの開発してます

本)AI覇権戦争_松田 雄馬_2026


AI覇権戦争 (SB新書)

AI覇権戦争 (SB新書)

Amazon


思っていたのと全然違う内容でしたが、、とても読みやすくためになる本でした。


タイトルから連想される国家間やAI企業間の争いの話も含みますがそれは導入に過ぎません。この本のメインは、現状のAIエコシステムに潜むリスクを整理したうえで、企業や個人がどのように意思決定を下し成長していけば良いか、について語っている点です。


抽象的な話が続くので読み手の想像力が求められる部分もありますが、一考に値する大事なことが書かれている本であることは確かです。


この本ではAIを盲目的に導入、使用することの危険性について強調されています。

今後もAI需要が高まり続けたら、電力が逼迫し、処理性能の制限・サービス価格の見直しのリスクとは常に隣り合わせの状況になるわけです。もし大きな変化が起きた場合、バックアッププランを持たないままAIアプリケーションを導入し業務に組み込んだ会社は、最悪仕事がストップしてしまうわけです。


また本書でも言及されていますが、今後数年の間に学習データの枯渇やAI自身によるデータの汚染が始まり、AIに対する信頼そのものが揺らぐことも考えられます。


そんな時代に人間はどのように考え行動するべきか? それがこの本のテーマです。著者の「体を動かし、感じ、問いを立て、仮説を設計する」という提案は共感はするけれど、簡単なことではないなあ、、、というのが僕の感想です。


でも、今のタイミングでこの本に出会えて良かったです。この本の内容をこれから度々思い出すことになりそうな気がします。


そういえば最近、韓国のSK hynixの来期のボーナスの試算額が一人当たり平均7000万円というニュースを見ました↓ すごい! AIデータセンターのメモリ需要が増えているからでしょう。そのため最近韓国では半導体技術者になりたい若者が増えているそうです。


でも、今のデータセンター需要がいつまで続くんだろうか? そんな風に将来を決めて本当に大丈夫なんだろうか、という気もしますね。


newsdig.tbs.co.jp

AI英語が完璧すぎて、逆に伝わらない件

僕は仕事で英語のメールやドキュメントを毎日作るんですが、AIが導入されて以来自分で直接英語で書くことはほとんどなくなりました。

ちょっとしたチャットくらいは直接英語で書くこともありますが、まとまった量の文章が必要な時はまず日本語で書いてAIに翻訳させています。最近は翻訳のクオリティが高いので、結果的に自力で英語で書くより速いんですよね。


おそらく英語非ネイティブの人は皆同じことやってるんじゃないかな?

その証拠に、普段僕が社内外から受け取る英語テキストのレベルがめっちゃ上がってるんです(笑)


最近は日系企業から来る英語メールも非の打ち所のない完璧な英語になってます。「絶対自分で書いてねーだろ!」って内心思ってます(笑)


AI英語で一つ特徴的なのは、固有名詞に"the"を多用するところですかね。プロジェクト名、商品名等全部にthe、the、theとうるさい。ここでAIを使ったかどうかが分かる。

ですよね?多分同じこと思っている人多いはず。


なので僕は、相手になんとなくAIで書いたと思われたくないとき、送信する前にtheを固有名詞の前から消して回ってます(笑) いや、別にAIで書いたことがバレても何も問題ないんですが(笑)


んで、ここからが本題。

皆がAI英語を使うようになって、果たしてコミュニケーションは円滑になっただろうか?


→なってない!


AI英語の欠点はあまりにも完璧すぎる所。つまり、文脈にふさわしい語彙や構文を”手加減なし”でチョイスするので、読み手の能力を超えた難しい文章になることがあるんです。


取引先からのメールにも、最近はこれまで一度も聞いたことのない難しい単語や言い回しが含まれるようになってきました。そのため、メールを理解するのにもAIの助けが必要な状況になってます(笑)


そもそも、コミュニケーションってキャッチボールなんです。

受け手がプロ野球選手だったら、AIでブーストされた150キロの球を投げても問題なく取ってくれるでしょう。

でも、相手が野球を始めたばかりの素人だったら?その人でも取れるようにゆっくり投げなきゃダメでしょう?


この点を踏まえると、以下が現状僕がベストだと思う英文メールの書き方。


①まず日本語で全部書く。この際、翻訳後にもセンテンス間の論理関係が明確になるように接続詞をしっかり書くのがポイント(だから、しかし、等)


②AIで翻訳する


③翻訳された英語を相手に合わせて、カスタマイズする。

非ネイティブに送る時は、自分が一度も聞いたことがない単語は別の良く使う単語に書き換える。長い文章は短文に分解する。 →送信


特に③が腕の見せ所です。ここは経験と勘が必要。必要なら英語的正しさや文章の美しさを損なっても構わない。ここをうまくやれば、一発で理解してもらえます。


余談ですが、僕はドイツ語でメールを書くときは③をすっ飛ばして、AIドイツ語をろくに中身も確認せずにそのまま送ってます。だって相手はドイツ人だから。どんな暴投をかましたって取ってくれるはず。


実際それでドイツ人とのコミュニケーションで問題が発生したことは一度もありません。ドイツ語においてもAIの翻訳レベルはものすごく上がってきているのでしょう。(僕のドイツ語力では確認不能ですが)


うちの会社、採用凍結してるっぽい

今日マネージャーから聞いて驚いたのですが、うちの会社、採用を全社的に止めているらしいです(!) いつからそうなったのかは聞きませんでしたが、少なくとも今は退職者が出た場合の人員補充に限定しており、部署を拡充したり新規事業のための採用は全く行っていないとのこと。


うちの部署にはずっと新しい人が入ってきていないので採用を凍結していることは知ってましたが、まさか全部署でそうなっているとは。。


詳しいことはそのうちに説明があるのでしょうが、まあ、もっともらしいことを言うんでしょうね。 地政学的リスク、アメリカの暴走、半導体の高騰、そしてAIの台頭、あたりでしょうか。


っていうかね、経営層もAIが訳わからなすぎて、これから会社として何やればいいか分からないんでしょうね(笑) 何に投資して、どう開発すればいいのか分からない。


そりゃそうだ!(笑) それは誰も分からん!(笑)  


だから今はできるだけ固定費を減らして、会社をコンパクトに保って、いつか道筋が見えた時に舵を切れるようにしたいのでしょう。 


そういえば去年あたりまでLinkedInで毎月のように来ていたリクルーターからのコンタクトも最近はめっきり来なくなった、、、ドイツや他のヨーロッパの会社も同じく採用減らしているのかなぁ? それとも、僕が40歳になったから需要が減っただけかな?(笑)

良いポジションがあったら転職したかったんだけど、もう無理かな。。。


AIと言えばこの前、新しい社内用システムを作る話を聞きました。部署で持っている全ての技術資料をAIに学習させて、AIに質問すれば開発に必要な情報を全部答えてくれるようにするらしいです。


良いアイデアだなと思いました。てか誰でも思いつきそうなものだし、既にそうやってる会社もあるんでしょうけど。。


まず情報を探す手間が省けるし、会議用のドキュメント作成もやってくれるでしょう。複数の製品仕様書を参照して、比較表を作ったりする場合にとても便利。

(社内の機密情報をAIに渡すことに、どんなセキュリティリスクがあるのか知らんけど)


うちの部署には、AIエキスパート社員がいるのですがどうもその人が発案したようです。


聞くところによると、アメリカや日本でもエントリー社員の採用が減っているらしいですが、AIに詳しい若手はとりあえず採用しとけば得することあるんじゃないかな?


上の例のようなアイデアをAIネイティブの若者達ならどんどん提案できるんじゃないですかね?彼らなら既存のシステムの非合理な部分に良く気が付いたりして。「なぜAIを使ってこういうシステムにしないんだろう?」って。


逆にある程度年齢のいった社員になると、アイデアを思い付いたとしても面倒臭さが勝って既存のシステムを大きく変更しようと思わなくなるだろうし。


はい、以上。どうせならちょっと前向きなことも書きたいと思って、、今日はこういう記事になりました(笑)


Netflixドラマ『グランパは新米スパイ(シーズン2)』感想

週末に1話ずつ見るのが習慣になっていた『グランパは新米スパイ』。(←改めて邦題ダサいw)あっという間にシーズン2も見終わってしまいました。

うーん、悪くはないのだが。。ぶっちゃけシーズン1の方が面白かったかな。

シーズン2ではグランパが大学に潜入するわけだけど、単純にストーリーが良く分からなかったんですよね(笑)


でも過度に感動的にならず淡々と進むところは見やすいドラマだと思います。ずっとハイスピードに軽妙なセリフの応酬が続いて、悲しい時もシリアスな時も、必ず誰かがどうでもいいことを言ったり絶妙な皮肉を言ったりするので、暗くならない。こういうのはいかにもアメリカのコメディ。


このドラマのメッセージは、「人は歳を取っても、新しい友人を作れる。新しいことを始められる。そして、自分の居場所をもう一度見つけることができる。」ということだと思いました。

なんか共感しましたね~。最後はシーズン1の人たちも含めて登場人物皆が仲良くなる感じ、すごく良かったです。


ちなみに見終わってから知ったけど、このドラマって実話がベースなんですってね!?

チリのドキュメンタリー映画『The Mole Agent(邦題:83歳のやさしいスパイ)』が原案とのこと。こっちは観てませんが、83歳の老人が探偵に雇われて本当に老人ホームに潜入するドキュメンタリーらしい。こういう老後も楽しそうですね(笑)

イメージセンサの評価を学ぶなら、EMVA 1288がとても良い

画質チームに異動になってからずっと「イメージセンサの評価を体系的に学びたいな~」とうっすら頭の片隅で思っていた僕ですが、最近ようやく手を付け始めました。


いろいろ教材を探したんですが、今勉強しているのはEMVA 1288の規格です。EMVA(European Machine Vision Association)は欧州のMachine Vision業界団体で、EMVA 1288はカメラやイメージセンサの性能評価方法を定めた規格です。


僕はずっと(ミラーレスに代表される)コンシューマーカメラ業界にいるのでCIPAの規格ばかりフォローしていて、これまでEMVAについては全然知りませんでした。

(ってか、日本ではEMVAって知名度低くないですか?そんなことない?僕が知らなかっただけ?)


ひとまずEMVA1288 Release 4.0の紹介用のWebinar(全4回、各約30分)を通して見ましたが、全体像がつかめてよかったです。英語も比較的聞き取りやすかったですね。

Webinar series on EMVA1288 Release 4.0 – EMVA


特にEMVA 1288でも重要な役割を果たすPTC(Photon Transfer Curve)について丁寧に解説されている点が良かったです。PTCがノイズやシステムゲインとどんな関係なのか初めて理解できました。。。


実は普段のミーティングでPTCってよく出てくる言葉なんですが、ずっと「良く分からんな~」って思っていたんです。。。そもそも日本時代は聞いたこともなかった。


でもちゃんと解説されればなんてことはない、日本時代からもともと知識としては理解していた事柄だったわけですが、やはり英語の現場ではこのような用語も英語で理解しておかないと議論についていけないですね。。。


イメージング領域のエンジニアの方でこれから外資系企業に行かれる方は、EMVA 1288を英語で理解していればセンサ関連の議論にはスムーズに入っていけると思います。


さらに興味深いのがEMVAは2023年にEMVA 1288を国際規格にすることをISOへ提案し、現在も標準化作業が進んでいるらしいです。今のうちに勉強しとくとなおさら良いかも!?


僕もこれからEMVA 1288の公式ドキュメント(規格書)の方を読んでみようかと思ってます↓

https://www.emva.org/wp-content/uploads/EMVA1288Linear_4.0Release.pdf

メタデータの無いRAW画像を簡易現像するPythonツールを作りました

はじめに

普段の仕事の延長なのですが、RAW画像を簡易現像するPythonツールを作ってみました。

先に、このツールのちょっと特殊な点に触れておきます。

PythonでRAW現像といえば、市販カメラで撮影したRAWファイル(DNGやARWなど)をrawpyで読み込む方法がよく紹介されています。こうしたRAWファイルには、カメラ名やベイヤーパターン、ブラックレベル、ホワイトバランスなど、現像に必要なさまざまな情報がメタデータとして記録されており、rawpyを使えばそれらを取得して現像処理に利用できます。

一方開発現場では、試作品や評価キットで撮影したまだ十分なメタデータを持たないRAWデータを扱うことがあります。そんなときは、仕様書を確認しながら現像パラメータを自分で指定しなければなりません。

また、市販カメラが出力するRAWファイルには、圧縮をはじめ、機種によっては各種の補正や変換が施されている場合があります。通常の写真用途では必要な処理ですが、センサー出力に近い状態で評価したい場合には、こうした処理を避けたいこともあります。
そのため開発現場では、あえて評価キット等から出力したより生の状態に近いRAWデータを使用することもしばしばあります。

というわけで今回は、メタデータを持たない生のRAWデータも扱えるよう、rawpyには頼らず、NumPyのみを使って現像処理を組み立てる方針でツールを作成しました。


目次

完成結果

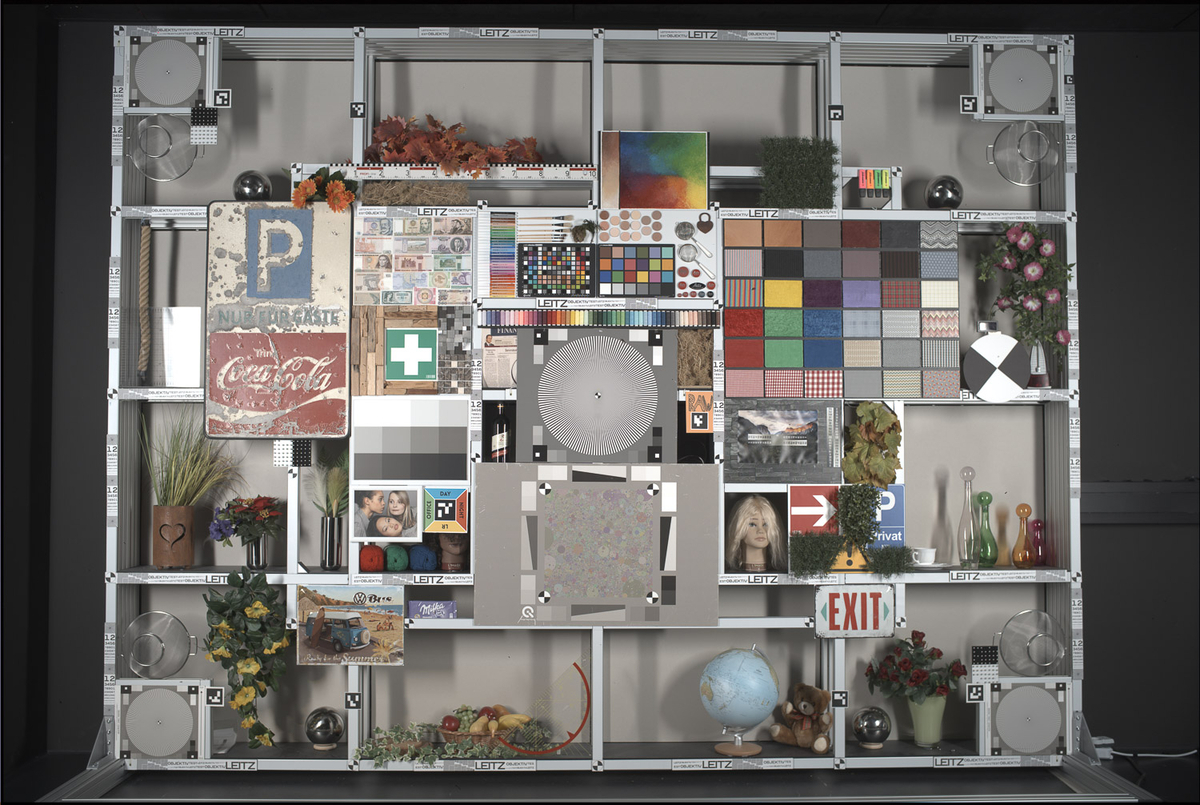
こちらが完成結果のカラー画像です。

完成結果(gamma.png)

詳しくは後ほど解説しますが、このツールでは画像処理パイプラインのうち、基本的なもののみを扱っています。
途中結果もPNGとして保存するため、各処理による変化を確認できます。

なおRAW画像の撮影には(会社に転がっていた)某社製センサ評価キットを使いました。

簡易RAW現像ツールのダウンロードと使い方

【ダウンロード】
作成したツールは以下からダウンロードできます。
[basic-raw-developerをダウンロード(ZIP:約189MB)]
basic-raw-developer.zip - Google ドライブ
ZIPにはソースコードと動作確認用のRAW画像2枚が含まれています。そのため、展開後すぐに処理を試せます。

basic-raw-developer
カメラ由来の現像用メタデータを持たない、ベイヤーRAW画像を現像する簡易Pythonツールです。
1画素を2バイトの符号なし整数として保存したRAWファイルを読み込み、以下の処理を行います。

・ブラックレベル補正
・ホワイトバランス補正
・デモザイク
・正規化
・ガンマ補正

ARWやDNGなどのカメラRAW形式ではなく、イメージセンサーなどから出力されたシンプルな画素データを処理することを目的としています。

【動作確認環境】
以下の環境で動作を確認しています。

・OS:Windows 11
・Python:3.14.6
・NumPy:2.5.1
・Matplotlib:3.11.1
・Pillow:12.3.0

ほかのWindows環境やmacOSでは未検証です。Pythonと必要なライブラリをインストールすれば動作する可能性がありますが、すべての環境での動作は保証していません。

【フォルダ構成】
basic-raw-developerフォルダには、以下のファイルとフォルダが含まれています。

・input
入力RAWファイルを保存するフォルダです。

・output
処理結果のPNG画像を保存するフォルダです。

・tools
RAW現像の各処理を実装したPythonモジュールが入っています。

・main.py
RAW現像パイプラインを実行するメインプログラムです。

・requirements.txt
必要なPythonライブラリが書かれています。

・README.md
ツールの説明が書かれています。

【インストール】
ターミナルでbasic-raw-developerフォルダへ移動し、必要なライブラリをインストールします。

Windowsの場合:
python -m pip install -r requirements.txt

macOSの場合:
python3 -m pip install -r requirements.txt

【実行方法】
Windowsの場合:
python main.py

macOSの場合:
python3 main.py

ホワイトバランス調整用の画像が表示されたら、無彩色領域をマウスで選択し、Enterキーを押してください。
処理結果はoutputフォルダへ保存されます。

【入力RAWファイルの構造】
入力RAWファイルの画素データには、次の条件があります。

・1画素につき2バイト
・符号なし16bit整数として保存
・バイト順はリトルエンディアン
・非圧縮
・1画素につき1つのベイヤー画素値

ファイルの拡張子は問いません。今回のサンプルでは.binを使用していますが、内部構造が上記の条件を満たしていれば、.rawや.datなどの拡張子でも読み込めます。
10bit、12bit、14bitなどの画素値を、1画素につき2バイトのuint16として保存している場合に使用できます。例えば12bitの画素値であれば、値の範囲は通常0~4095ですが、ファイル内では各画素に2バイトを使用します。
10bit画素値 → 2バイトで保存
12bit画素値 → 2バイトで保存
14bit画素値 → 2バイトで保存
複数の画素を隙間なく詰め込む、10bit packed形式や12bit packed形式には対応していません。

【入力ファイルの変更】
入力ファイルを変更する場合は、main.pyのCALIBRATION_FILEとRAW_FILEを変更します。

CALIBRATION_FILE:
PROJECT_DIR / "input" / "ホワイトバランス用RAWファイル.bin"

RAW_FILE:
PROJECT_DIR / "input" / "現像対象RAWファイル.bin"

CALIBRATION_FILEは、ホワイトバランスのゲイン計算に使用する無彩色画像です。
RAW_FILEは、実際に現像する画像です。
拡張子を変更する場合は、ここで実際のファイル名を指定してください。

【使用上の注意】
このツールでは、入力RAWに関する一部の条件をサンプル画像の仕様に合わせコード内で指定しています。

・画像幅と画像高さの値の格納位置 → 先頭2バイト:画像幅、次の2バイト:画像高さ
・画素データの格納位置 → 5バイト目以降
・ベイヤーパターン → 左上画素がR画素のRGGBパターンとして指定
・ブラックレベル → HOPBエリアを検波し、1022DN@14bitを指定 
・ホワイトバランスの求め方 → 無彩色エリアでは画素値はG,B,Rの順になると推定
・正規化に使用するパーセンタイル値 → 99%を指定
・ガンマ値 → 2.2を指定

異なるイメージセンサーやRAW形式を使用する場合は、これらの設定を入力データに合わせて変更してください。特に、画素値のビット深度が変わると、適切なブラックレベルや画素値の範囲も変わる可能性があります。

【対応していないRAW形式】
このツールは、以下のようなカメラRAWファイルを直接読み込むものではありません。
・ARW
・DNG
・NEF
・CR2
・CR3
これらの形式には、メタデータ、プレビュー画像、圧縮された画素データなどが含まれているため、専用の読み込み処理が必要です。

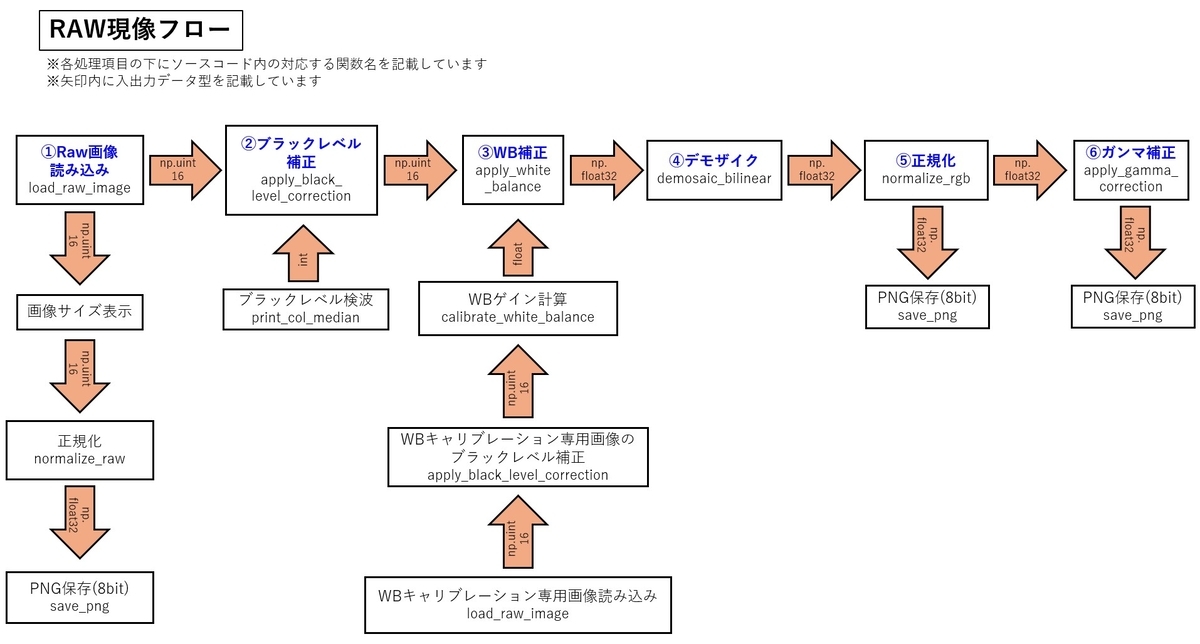
RAW現像処理の全体像

上のフローチャートは、今回作成したツールの処理全体を示しています。
現像対象のRAW画像に対して、次の処理を順番に行います。

① RAW画像の読み込み
② ブラックレベル補正
③ ホワイトバランス補正
④ デモザイク
⑤ 正規化
⑥ ガンマ補正

ホワイトバランス補正に使用するゲインは、別途用意したキャリブレーション画像の無彩色領域から計算します。
また、処理結果を確認できるように、RAW読み込み直後、デモザイク・正規化後、ガンマ補正後の画像を8bit PNGとして保存します。
フローチャートの各処理欄には対応する関数名を、矢印内には処理間で受け渡されるNumPy配列のデータ型を記載しています。
各処理の詳しい内容とソースコードについては、以降で説明します。

ソースコードの構成

今回のツールでは、RAW現像の各処理を機能ごとに別のPythonファイルへ分けています。toolsフォルダ内の各Pythonファイルが「モジュール」、その中に定義されている個別の処理が「関数」です。
各モジュールの役割は以下のとおりです。

・raw_reader.py
RAWファイルを読み込む

・print_col_median.py
先頭100列の画素値の中央値を表示する → ブラックレベル検波に使用します

・black_level.py
ブラックレベルを補正する

・white_balance_calibration.py
無彩色画像からホワイトバランスゲインを計算する

・white_balance.py
RAW画像にホワイトバランスゲインを適用する

・demosaic.py
ベイヤーRAW画像をRGB画像へ変換する

・normalization.py
RAW画像とRGB画像を0.0~1.0へ正規化する

・gamma.py
RGB画像にガンマ補正を適用する

・png_writer.py
処理結果を8bit PNGとして保存する

main.pyでは、これらのモジュールから必要な関数をインポートし、RAW現像の順番に呼び出しています。

ソースコード解説

RAW現像フローに沿って、ソースコードを解説します。

①RAW画像読み込み

個人的にこの画像読み込み部分が最初にして最大の山場でした...
メタデータがある場合はrawpyで画素数情報を読み取り簡単に2次元Numpy配列を作れるのですが、メタデータが無い場合は、自力で画素数情報を読みとり、配列を準備しなければいけません。

raw_reader.pyのload_raw_image関数を使ってRAW画像を読み込みます。
以下がraw_reader.pyのソースコードです。

from pathlib import Path
import struct

import numpy as np


def load_raw_image(file_path: Path) -> np.ndarray:
    """バイナリファイルから16ビットRAW画像を読み込む。"""

    if not file_path.exists():
        raise FileNotFoundError(
            f"RAW file not found: {file_path}"
        )

    # 4バイトのヘッダーから画像サイズを読み込む。
    with file_path.open("rb") as file:
        width = struct.unpack("<H", file.read(2))[0]
        height = struct.unpack("<H", file.read(2))[0]

    # 4バイトのヘッダーに続く16ビット画素データを読み込む。
    raw = np.fromfile(
        file_path,
        dtype="<u2",
        offset=4,
        count=width * height,
    )

    expected_pixels = width * height

    # 想定した画素数を読み込めたか確認する。
    if raw.size != expected_pixels:
        raise ValueError(
            "Pixel count does not match. "
            f"Expected={expected_pixels}, loaded={raw.size}"
        )

    # 1次元の画素配列を2次元画像へ変換する。
    return raw.reshape(height, width)

今回使用したRAWファイルは、ヘッダー部に画素数情報が埋め込まれており、その後に画素データが入っています。
つまり、
先頭2バイト:画像幅
次の2バイト:画像高さ
5バイト目以降:1画素につき2バイトの画素データ
という構成。
※1画素の有効bit数は14bitです

画像幅と高さは、struct.unpack関数を使って読み込みます。「<H」の「<」はリトルエンディアン、「H」は2バイトの符号なし整数を表します。

画素データは、NumPyのfromfile関数を使って読み込みます。これでまず一次元配列ができます。
dtypeには「<u2」を指定しています。これは、リトルエンディアンで保存された2バイトの符号なし整数を意味します。
offset=4を指定することで、画像幅と高さが格納されている先頭4バイトを飛ばし、5バイト目から画素データを読み込みます。

読み込んだ画素データは1次元配列なので、reshape関数を使って高さ×幅の2次元画像へ変換します。
load_raw_image関数が返す画像のデータ型はuint16です。

main.pyを実行すると、読み込んだ画像の幅は9609画素, 高さ6444画素であることがターミナルに表示されます。


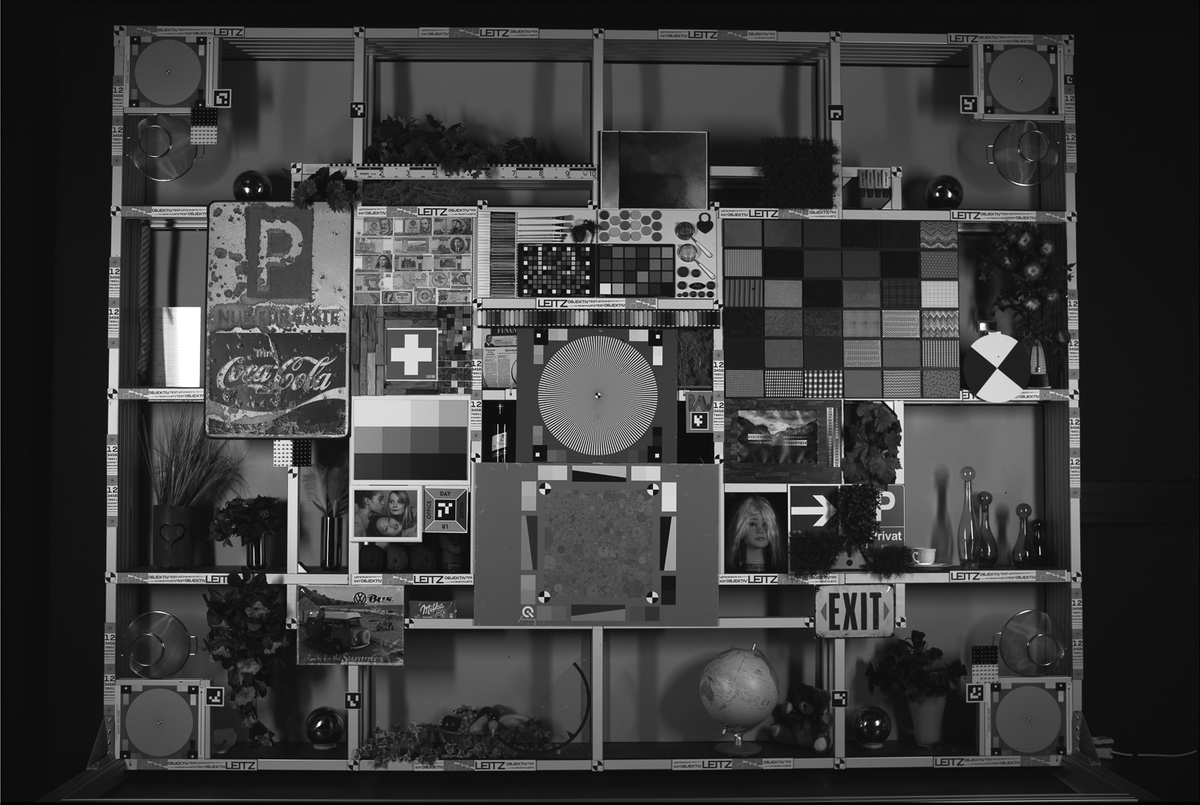
RAW画像読み込みの後、正規化、PNG保存(8bit)がmain.py上で実行されます。(これらの処理の詳細は後述)

raw.pngが保存されます

②ブラックレベル補正

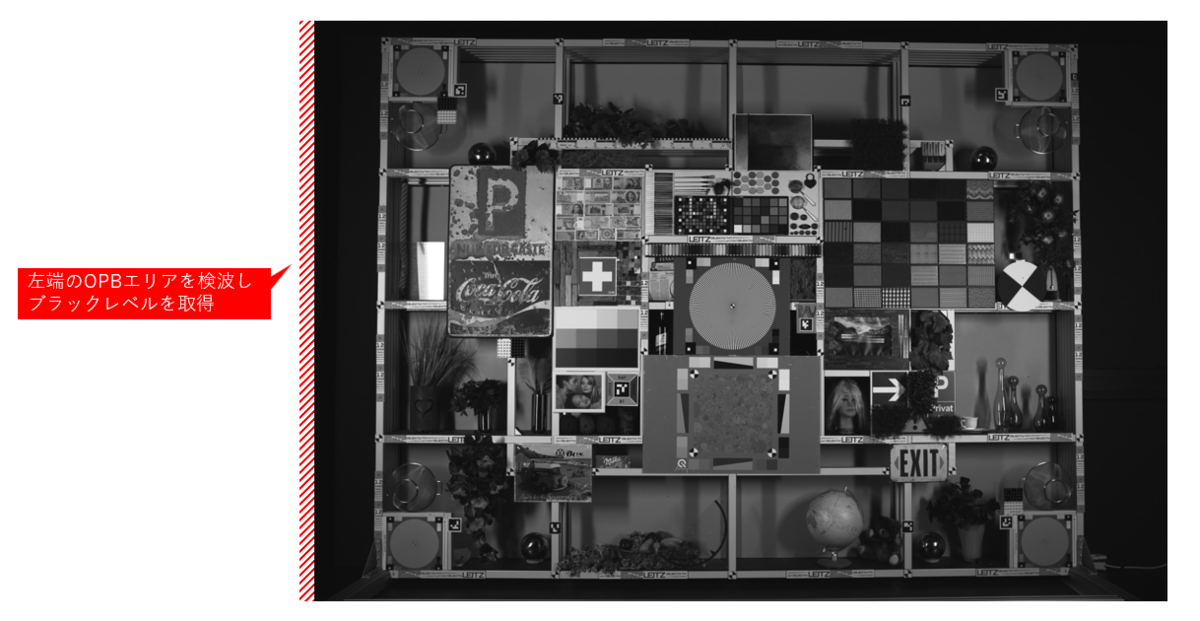
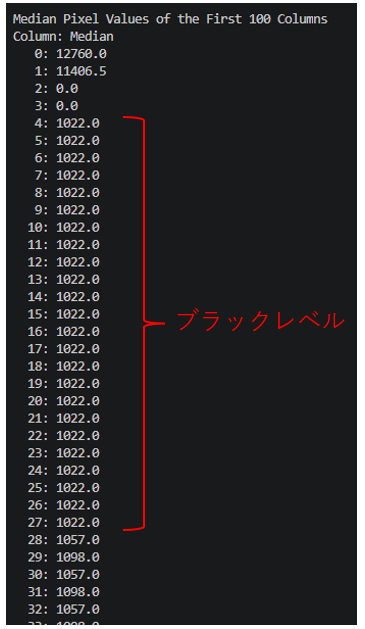
今回使用したRAW画像には左端にオプティカルブラック(OPB)が含まれているため、ざっくり先頭100列の画素値の中央値を確認します。

この処理には、print_col_median.pyのprint_col_median関数を使用します。
以下がprint_col_median.pyのソースコードです。

import numpy as np


def print_col_median(image: np.ndarray) -> None:
    """先頭100列の画素値の中央値を表示する。"""

    col_median = np.median(image[:, :100], axis=0)

    print("\nMedian Pixel Values of the First 100 Columns")
    print("Column: Median")

    for column, value in enumerate(col_median):
        print(f"{column:4d}: {value:.1f}")

np.median関数のaxis=0は、行方向に画素値を集計し、各列の中央値を求める指定です。
※ノイズや欠陥画素による外れ値の影響を除くため、平均値ではなく中央値を使用しました。

ターミナルに表示された中央値からブラックレベルを確認すると、1022DN@14bitのようです。こちらをブラックレベル補正に使用します。

実際の補正処理は、black_level.pyのapply_black_level_correction関数で行います。
補正では、すべての画素から一定のブラックレベルを減算します。(理想的には色毎にブラックレベルを検波・減算すべきですが今回は簡易ツールなので...)

以下がblack_level.pyのソースコードです。

import numpy as np


def apply_black_level_correction(
    image: np.ndarray,
    black_level: int = 1022,
) -> np.ndarray:
    """
    シンプルなブラックレベル補正を適用する。

    すべての画素から一定のブラックレベルを引き、
    負の値は0にクリップする。

    引数
    ----------
    image : np.ndarray
        2次元RAW画像。

    black_level : int, 任意
        すべての画素から引くブラックレベル。
        デフォルトは1022。

    戻り値
    -------
    np.ndarray
        ブラックレベル補正済みのRAW画像。
    """

    # uint16のアンダーフローを避けるため、符号付き整数へ変換する。
    corrected = image.astype(np.int32)

    # ブラックレベルを引く。
    corrected -= black_level

    # 負の値を0に丸める。
    corrected = np.clip(corrected, 0, None)

    return corrected.astype(np.uint16)

uint16のまま減算すると、結果が負になった場合にアンダーフローが発生します。そのため、一度int32へ変換してからブラックレベルを引いています。

減算後に負となった画素値は、np.clip関数を使って0に収めます。最後に、画像のデータ型をuint16へ戻します。

③ホワイトバランス(WB)補正

ホワイトバランス(WB)補正は、次の2段階に分けて行います。
まず、キャリブレーション専用のRAW画像からWBゲイン(RゲインとBゲイン)を求めます。
次に、求めたゲインを現像対象のRAW画像へ適用します。

現像対象のRAW画像に飽和していない均一な無彩色領域(白い壁等)が含まれていれば、その領域からWBゲインを求めることも可能です。
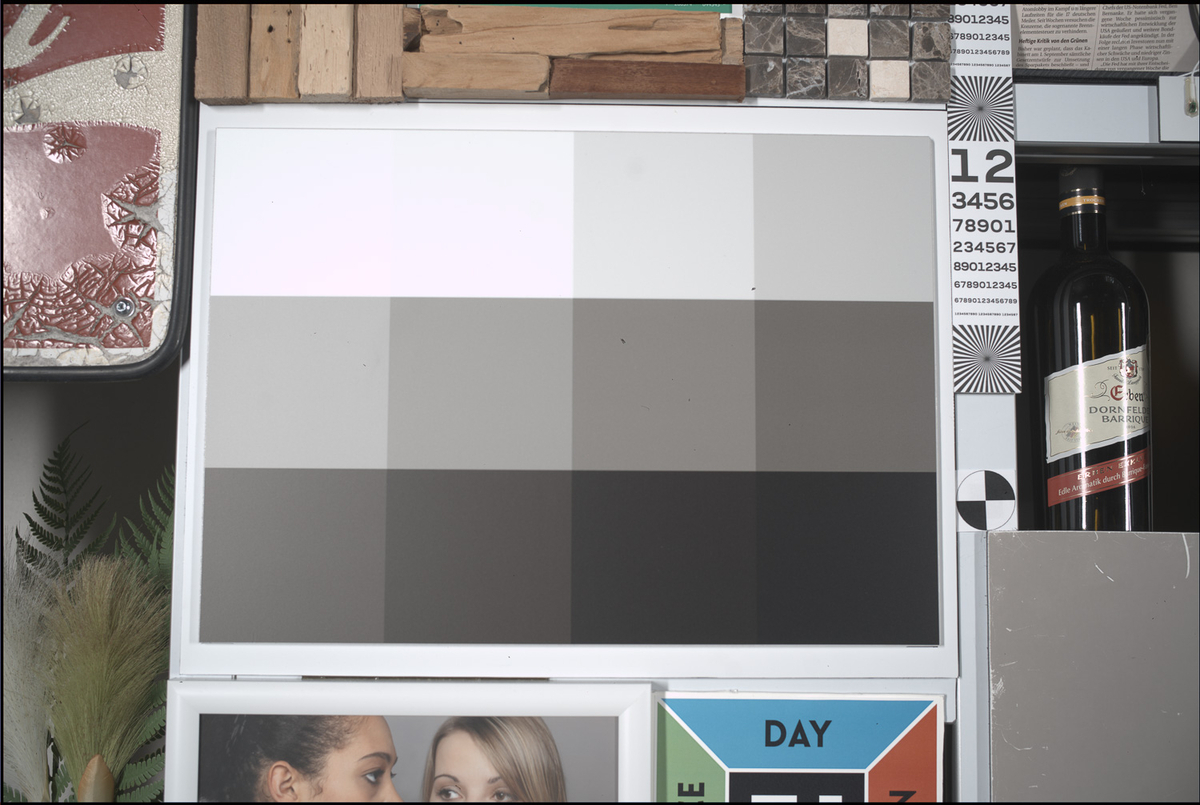
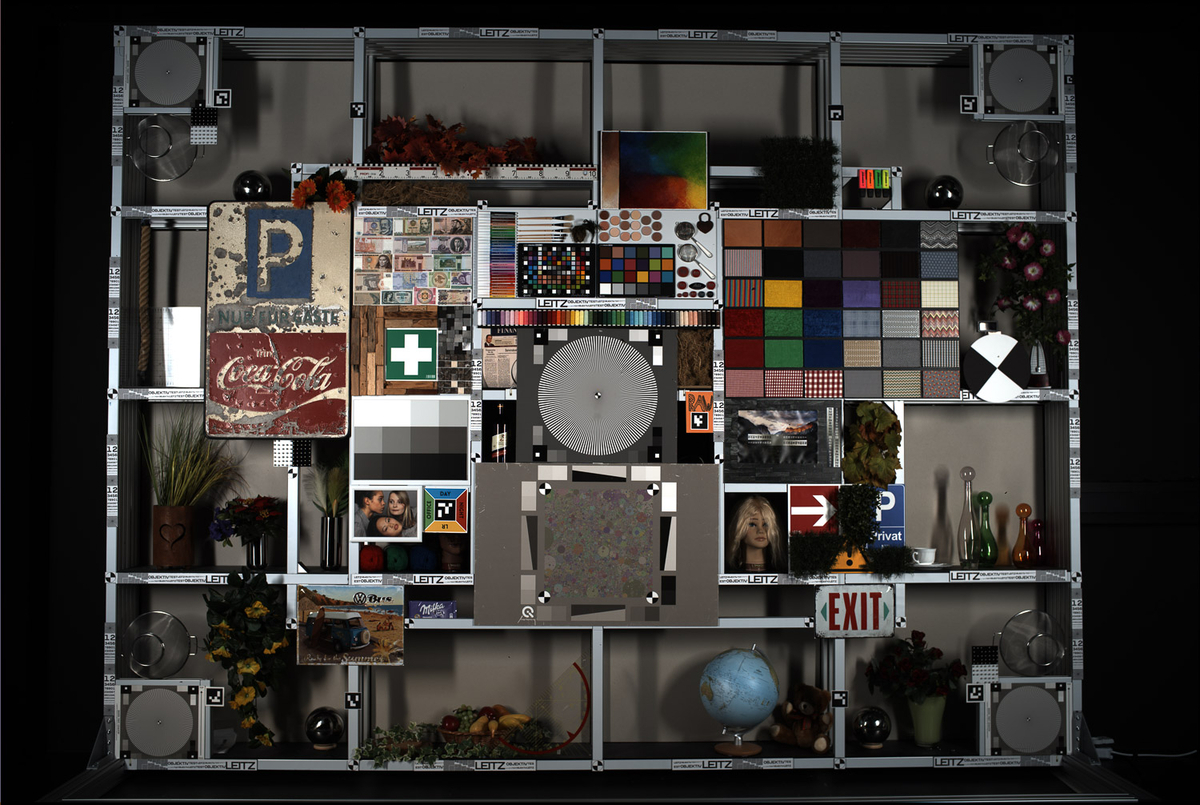
今回はこのような無彩色チャートを撮影した専用のキャリブレーション画像を別に用意しました。

キャリブレーション画像

キャリブレーション画像と現像対象画像で照明の種類や色温度が変わると、求めたWBゲインが適切でなくなるため、両方を同じ照明条件で撮影する必要があります。

キャリブレーション画像を読み込んだら、まずブラックレベル補正がmain.pyから実行されます。(ブラックレベル補正をしないと、後のWBゲインの計算結果がおかしくなります)

WBゲインの計算には、white_balance_calibration.pyのcalibrate_white_balance関数を使用します。
以下がwhite_balance_calibration.pyのソースコードです。

import matplotlib.pyplot as plt
import numpy as np
from matplotlib.widgets import RectangleSelector

def calibrate_white_balance(
    image: np.ndarray,
) -> tuple[float, float]:
    """
    無彩色チャート画像からホワイトバランスゲインを求める。

    処理内容
    ----------
    1. マウスで無彩色領域をROI選択する。
    2. ROIを4つのベイヤー位置に分ける。
    3. 信号レベルが高い2位置をGとみなす。
    4. 残り2位置のうち、高い方をB、低い方をRとみなす。
    5. Gを1.0としてRとBのゲインを計算する。

    前提
    ----------
    - imageはブラックレベル補正済み。
    - 選択するROIは均一な無彩色領域。
    - Gの信号レベルがR/Bより高い。
    - Bの信号レベルがRより高い。
    - GrとGbのゲインはどちらも1.0とする。

    引数
    ----------
    image : np.ndarray
        ブラックレベル補正済みの2次元RAW画像。

    戻り値
    -------
    tuple[float, float]
        RゲインとBゲイン。
    """

    if image.ndim != 2:
        raise ValueError("imageは2次元RAW画像である必要があります。")

    selected_roi = None

    def on_select(eclick, erelease) -> None:
        """マウスで選択したROIの座標を保存する。"""
        nonlocal selected_roi

        if (
            eclick.xdata is None
            or eclick.ydata is None
            or erelease.xdata is None
            or erelease.ydata is None
        ):
            return

        x0 = int(min(eclick.xdata, erelease.xdata))
        y0 = int(min(eclick.ydata, erelease.ydata))
        x1 = int(max(eclick.xdata, erelease.xdata))
        y1 = int(max(eclick.ydata, erelease.ydata))

        selected_roi = (x0, y0, x1, y1)

    # キャリブレーション画像を表示する。
    fig, ax = plt.subplots(figsize=(12, 8))

    ax.imshow(
        image,
        cmap="gray",
        vmin=np.percentile(image, 1),
        vmax=np.percentile(image, 99),
    )

    ax.set_title(
        "Select a neutral area and press Enter"
    )

    ax.set_xlabel("Column")
    ax.set_ylabel("Row")

    selector = RectangleSelector(
        ax,
        on_select,
        button=[1],
        useblit=True,
        interactive=True,
    )

    def on_key_press(event) -> None:
        """Enterキーが押されたら画像ウィンドウを閉じる。"""
        if event.key == "enter":
            plt.close(fig)

    # キーボード入力を監視する。
    fig.canvas.mpl_connect("key_press_event", on_key_press)

    plt.tight_layout()
    plt.show()

    # ROI選択オブジェクトが途中で破棄されないように保持する。
    _ = selector

    if selected_roi is None:
        raise RuntimeError("ROIが選択されていません。")

    x0, y0, x1, y1 = selected_roi

    if x1 - x0 < 2 or y1 - y0 < 2:
        raise ValueError("選択したROIが小さすぎます。")

    # 選択したROIを切り出す。
    roi = image[y0:y1, x0:x1]

    # ROIを4つのベイヤー位置に分ける。
    p00 = roi[0::2, 0::2]
    p01 = roi[0::2, 1::2]
    p10 = roi[1::2, 0::2]
    p11 = roi[1::2, 1::2]

    # 各ベイヤー位置の中央値を求める。
    levels = {
        "00": float(np.median(p00)),
        "01": float(np.median(p01)),
        "10": float(np.median(p10)),
        "11": float(np.median(p11)),
    }

    # 信号レベルが高い順に並べる。
    ordered_positions = sorted(
        levels,
        key=levels.get,
        reverse=True,
    )

    # 上位2つをGとみなす。
    green_positions = ordered_positions[:2]

    # 残り2つをR/B候補とする。
    red_blue_positions = ordered_positions[2:]

    # Bの方がRより感度が高いと仮定する。
    blue_position = max(
        red_blue_positions,
        key=levels.get,
    )

    red_position = min(
        red_blue_positions,
        key=levels.get,
    )

    # R/G/Bの代表値を取得する。
    red_median = levels[red_position]

    green_median = (
        levels[green_positions[0]]
        + levels[green_positions[1]]
    ) / 2.0

    blue_median = levels[blue_position]

    if red_median <= 0 or blue_median <= 0:
        raise ValueError(
            "RまたはBの信号レベルが0以下です。"
            "別のROIを選択してください。"
        )

    # Gを1.0としてホワイトバランスゲインを計算する。
    red_gain = green_median / red_median
    blue_gain = green_median / blue_median

    print("\nWhite-balance gains:")
    print(f"R gain: {red_gain:.6f}")
    print("G gain: 1.000000")
    print(f"B gain: {blue_gain:.6f}")

    return red_gain, blue_gain

このプログラムは、結構苦労しました...
AIが無かったらこんなの正直自力だけでは書けないです。(笑)

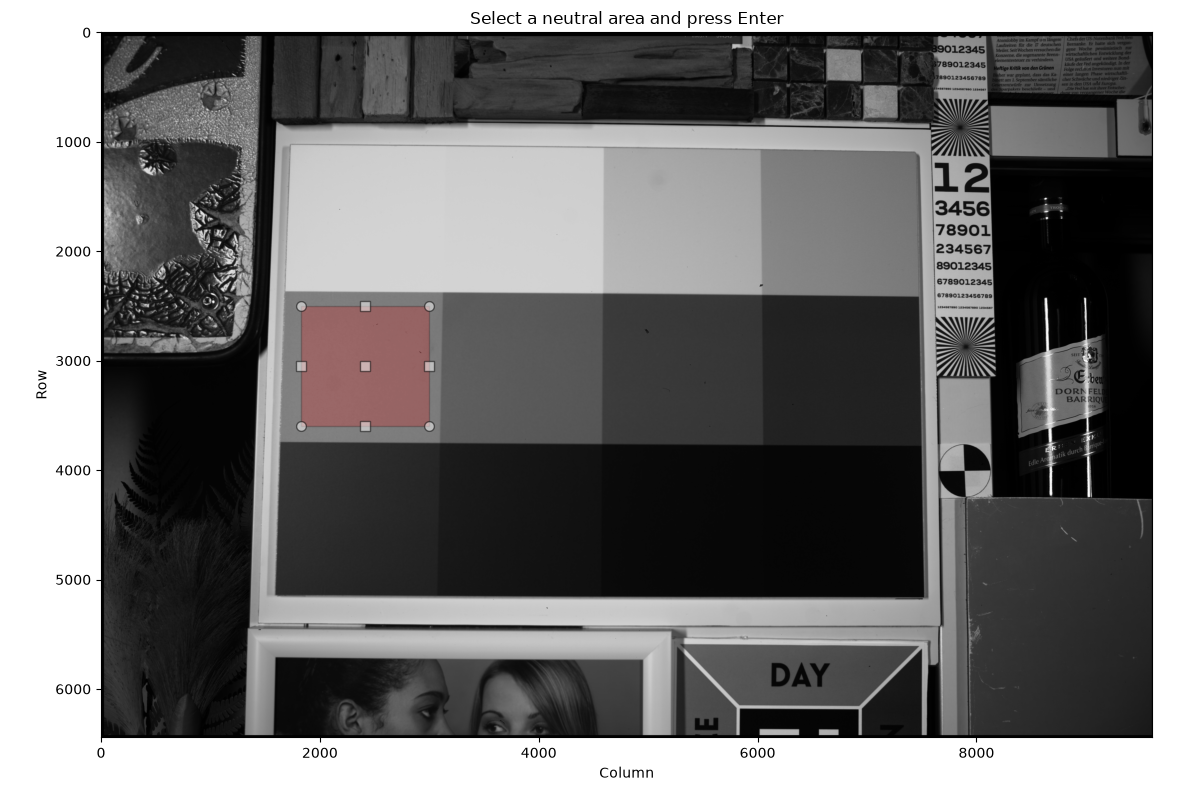
プログラムを実行すると、まずホワイトバランスキャリブレーション用の画像が表示されます。画像上で均一な無彩色領域をマウスで選択し、Enterキーを押して確定します。

選択した領域をベイヤー配列の4つの画素位置に分け、それぞれの画素値の中央値を計算します。

今回使用する画像では、無彩色領域の信号レベルが「G、B、R」の順に高くなることを利用しています。4つの信号レベルのうち、値が高い2つをGrとGb、残りのうち値が高い方をB、低い方をRとして判別します。

その後、GrとGbの平均値をGとし、RとBの信号レベルをGにそろえるためのWBゲインを計算します。

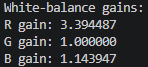
ターミナルにWBゲインの計算結果が表示されます。
今回6500Kの照明を使って撮影しましたが、下のような結果になりました。


次に、求めたWBゲインを現像対象のRAW画像へ適用します。この処理はwhite_balance.pyのapply_white_balance関数で行います。
以下がwhite_balance.pyのソースコードです。

import numpy as np


def apply_white_balance(
    image: np.ndarray,
    red_gain: float,
    blue_gain: float,
) -> np.ndarray:
    """
    RGGBベイヤーRAW画像にホワイトバランスゲインを適用する。

    ベイヤーパターンは以下を前提とする。

        R  Gr
        Gb B

    画像の左上画素 image[0, 0] はRとする。

    Gのゲインは1.0固定とし、
    R画素とB画素だけにゲインを掛ける。

    引数
    ----------
    image : np.ndarray
        ブラックレベル補正済みの2次元RAW画像。

    red_gain : float
        R画素に掛けるホワイトバランスゲイン。

    blue_gain : float
        B画素に掛けるホワイトバランスゲイン。

    戻り値
    -------
    np.ndarray
        ホワイトバランス補正済みのRAW画像。
    """

    if image.ndim != 2:
        raise ValueError(
            "imageは2次元RAW画像である必要があります。"
        )

    # ゲインを掛けると小数が発生するため、
    # float32へ変換してコピーを作る。
    corrected = image.astype(
        np.float32,
        copy=True,
    )

    # RGGBベイヤーパターン
    #
    # R  Gr
    # Gb B
    #
    # GrとGbはゲイン1.0なので何もしない。

    # R画素にRゲインを掛ける。
    corrected[0::2, 0::2] *= red_gain

    # B画素にBゲインを掛ける。
    corrected[1::2, 1::2] *= blue_gain

    return corrected

今回のベイヤーパターンは、左上から次のように並ぶRGGBです。

R Gr
Gb B

R画素にはRゲインを掛け、B画素にはBゲインを掛けます。Gr画素とGb画素のゲインは1.0としているため、値を変更しません。
ゲインを掛けると小数が発生するため、ホワイトバランス補正後の画像はfloat32になります。

④デモザイク

ベイヤーRAW画像では、各画素がR、G、Bのうち1色の情報しか持っていません。そこで、各画素に不足している色成分を周囲の画素から補間します。

今回のツールはあくまで簡易ツールなので、最もシンプルな方式である線形補間デモザイクを採用しています。つまり、周辺画素の平均値を使って値を補間しています。

こちらの処理はdemosaic.pyのdemosaic_bilinear関数を使います。
以下がdemosaic.pyのソースコードです。

import numpy as np


def demosaic_bilinear(image: np.ndarray) -> np.ndarray:
    """
    RGGB Bayer RAW画像を線形補間法でデモザイクする。

    Bayerパターンは以下を前提とする。

        R  G
        G  B

    各画素で不足している色成分を、
    周囲の同色画素の平均値で補間する。

    Parameters
    ----------
    image : np.ndarray
        ホワイトバランス補正済みの2次元Bayer RAW画像。

    Returns
    -------
    np.ndarray
        デモザイク後のRGB画像。
        shapeは (height, width, 3)。
        チャンネル順は R, G, B。
    """

    if image.ndim != 2:
        raise ValueError(
            "imageは2次元Bayer RAW画像である必要があります。"
        )

    # 計算用にfloat32へ変換する。
    raw = image.astype(np.float32)

    height, width = raw.shape

    # R, G, Bの3チャンネル画像を用意する。
    rgb = np.zeros(
        (height, width, 3),
        dtype=np.float32,
    )

    # --------------------------------------------------
    # 元のBayer画素を各RGBチャンネルへ配置
    # --------------------------------------------------

    # R画素
    rgb[0::2, 0::2, 0] = raw[0::2, 0::2]

    # G画素
    rgb[0::2, 1::2, 1] = raw[0::2, 1::2]

    # G画素
    rgb[1::2, 0::2, 1] = raw[1::2, 0::2]

    # B画素
    rgb[1::2, 1::2, 2] = raw[1::2, 1::2]

    # --------------------------------------------------
    # 画像端の処理を簡単にするため、
    # 周囲を1画素分コピーして拡張する。
    # --------------------------------------------------

    padded = np.pad(
        raw,
        1,
        mode="edge",
    )

    # 元画像に対応する周辺画素を取得する。
    up = padded[:-2, 1:-1]
    down = padded[2:, 1:-1]
    left = padded[1:-1, :-2]
    right = padded[1:-1, 2:]

    up_left = padded[:-2, :-2]
    up_right = padded[:-2, 2:]
    down_left = padded[2:, :-2]
    down_right = padded[2:, 2:]

    # --------------------------------------------------
    # Gチャンネルを補間
    # --------------------------------------------------

    # R位置とB位置では、
    # 上下左右4つのG画素を平均する。
    green = (
        up
        + down
        + left
        + right
    ) / 4.0

    rgb[0::2, 0::2, 1] = green[0::2, 0::2]
    rgb[1::2, 1::2, 1] = green[1::2, 1::2]

    # --------------------------------------------------
    # Rチャンネルを補間
    # --------------------------------------------------

    # G位置(Rと同じ行)では、
    # 左右のR画素を平均する。
    red_horizontal = (
        left
        + right
    ) / 2.0

    rgb[0::2, 1::2, 0] = red_horizontal[0::2, 1::2]

    # G位置(Rと同じ列)では、
    # 上下のR画素を平均する。
    red_vertical = (
        up
        + down
    ) / 2.0

    rgb[1::2, 0::2, 0] = red_vertical[1::2, 0::2]

    # B位置では、
    # 斜め4方向のR画素を平均する。
    red_diagonal = (
        up_left
        + up_right
        + down_left
        + down_right
    ) / 4.0

    rgb[1::2, 1::2, 0] = red_diagonal[1::2, 1::2]

    # --------------------------------------------------
    # Bチャンネルを補間
    # --------------------------------------------------

    # G位置(Bと同じ列)では、
    # 上下のB画素を平均する。
    blue_vertical = (
        up
        + down
    ) / 2.0

    rgb[0::2, 1::2, 2] = blue_vertical[0::2, 1::2]

    # G位置(Bと同じ行)では、
    # 左右のB画素を平均する。
    blue_horizontal = (
        left
        + right
    ) / 2.0

    rgb[1::2, 0::2, 2] = blue_horizontal[1::2, 0::2]

    # R位置では、
    # 斜め4方向のB画素を平均する。
    blue_diagonal = (
        up_left
        + up_right
        + down_left
        + down_right
    ) / 4.0

    rgb[0::2, 0::2, 2] = blue_diagonal[0::2, 0::2]

    return rgb

最初に、R、G、Bの3チャンネルを持つ空の配列を作り、元のベイヤー画素を対応するチャンネルへ配置します。
その後、Gチャンネル、Rチャンネル、Bチャンネルの不足している値を、上下左右または斜め方向にある画素の平均値から求めます。
入力は高さ×幅の2次元配列ですが、デモザイク後は高さ×幅×3のRGB配列になります。出力のデータ型はfloat32です。

⑤正規化

デモザイク後のRGB画像は、そのままではガンマ補正に適した範囲になっていません。そこで、normalization.pyのnormalize_rgb関数を使い、画素値を0.0~1.0の範囲へ正規化します。
以下がnormalization.pyのソースコードです。

import numpy as np


def normalize_raw(
    image: np.ndarray,
    percentile: float = 99.0,
) -> np.ndarray:
    """2次元RAW画像を0.0~1.0の範囲へ正規化する。"""

    if image.ndim != 2:
        raise ValueError(
            "imageは2次元RAW画像である必要があります。"
        )

    if not 0.0 < percentile <= 100.0:
        raise ValueError(
            "percentileは0より大きく100以下である必要があります。"
        )

    # 入力画像そのものは変更しない。
    normalized = image.astype(
        np.float32,
        copy=False,
    )

    # 指定したパーセンタイル値を正規化の基準にする。
    # 例えば99.0の場合、画素値の99%がこの値以下になる。
    maximum = float(
        np.percentile(
            normalized,
            percentile,
        )
    )

    if maximum <= 0:
        raise ValueError(
            "正規化に使用できる画素値がありません。"
        )

    normalized = normalized / maximum

    # 基準値を超えた画素を1.0に収める。
    normalized = np.clip(
        normalized,
        0.0,
        1.0,
    )

    return normalized


def normalize_rgb(
    image: np.ndarray,
    percentile: float = 99.0,
) -> np.ndarray:
    """RGB画像を0.0~1.0の範囲へ正規化する。"""

    if image.ndim != 3 or image.shape[2] != 3:
        raise ValueError(
            "imageはshape=(height, width, 3)のRGB画像である必要があります。"
        )

    if not 0.0 < percentile <= 100.0:
        raise ValueError(
            "percentileは0より大きく100以下である必要があります。"
        )

    # 入力画像そのものは変更しない。
    normalized = image.astype(
        np.float32,
        copy=False,
    )

    # 指定したパーセンタイル値を基準にする。
    maximum = float(
        np.percentile(
            normalized,
            percentile,
        )
    )

    if maximum <= 0:
        raise ValueError(
            "正規化に使用できる画素値がありません。"
        )

    normalized = normalized / maximum

    # 基準値を超えた画素を1.0に収める。
    normalized = np.clip(
        normalized,
        0.0,
        1.0,
    )

    return normalized

このモジュールには、2次元RAW画像用のnormalize_raw関数と、3チャンネルRGB画像用のnormalize_rgb関数があります。

今回の正規化では、画像内の最大値ではなく99パーセンタイル値を基準にしています。最大値を基準にすると、ごく少数の極端に明るい画素によって画像全体が暗くなる場合があります。99パーセンタイル値を使うことで、この影響を抑えています。

画素値を基準値で割ったあと、0.0未満を0.0、1.0を超えた値を1.0に収めます。
正規化後の画像データ型はfloat32です。

正規化の後、PNG保存(8bit)がmain.py上で実行されます。

demosaic.pngが保存されます

⑥ガンマ補正

デモザイク後のRGB画像は、画素値と光の強さがほぼ比例する線形画像です。そのまま表示すると、中間調が暗く見えます。
そこで、画素値を「1÷ガンマ値」乗し、表示しやすい明るさへ変換します。

正規化後のRGB画像に、gamma.pyのapply_gamma_correction関数を使ってガンマ補正を適用します。
以下がgamma.pyのソースコードです。

import numpy as np


def apply_gamma_correction(
    image: np.ndarray,
    gamma: float = 2.2,
) -> np.ndarray:
    """0.0~1.0の線形RGB画像にガンマ補正を適用する。"""

    if image.ndim != 3 or image.shape[2] != 3:
        raise ValueError(
            "imageはshape=(height, width, 3)のRGB画像である必要があります。"
        )

    if gamma <= 0:
        raise ValueError(
            "gammaは0より大きい必要があります。"
        )

    # 入力画像そのものは変更しない。
    corrected = image.astype(
        np.float32,
        copy=False,
    )

    # 線形データを表示用の明るさへ変換する。
    corrected = corrected ** (1.0 / gamma)

    return corrected

今回のガンマ値は2.2です。

ガンマ補正の中心となる処理は、次の計算です。
corrected = corrected ** (1.0 / gamma)

入力画像と出力画像は、どちらも0.0~1.0の範囲を持つfloat32のRGB画像です。

ガンマ補正の後、PNG保存(8bit)がmain.py上で実行されます。

gamma.pngが保存されます

8bitPNG保存

各処理段階の画像は、png_writer.pyのsave_png関数を使って8bit PNGとして保存します。
以下がpng_writer.pyのソースコードです。

from pathlib import Path

import numpy as np
from PIL import Image


def save_png(
    image: np.ndarray,
    file_path: Path,
) -> None:
    """0.0~1.0の画像を8bit PNGとして保存する。"""

    if image.ndim == 2:
        mode = "L"
    elif image.ndim == 3 and image.shape[2] == 3:
        mode = "RGB"
    else:
        raise ValueError(
            "imageは2次元画像またはRGB画像である必要があります。"
        )

    image_uint8 = np.rint(
        np.clip(image, 0.0, 1.0) * 255.0
    ).astype(np.uint8)

    Image.fromarray(
        image_uint8,
        mode=mode,
    ).save(file_path)

save_png関数は、入力画像が2次元画像かRGB画像かを判定します。2次元画像の場合はグレースケール、3チャンネル画像の場合はRGBとして保存します。

入力画像の画素値は0.0~1.0なので、255を掛けて0~255へ変換します。
その後、四捨五入してuint8へ変換し、Pillowを使ってPNGファイルとして保存します。

今回のツールでは、次の3枚をoutputフォルダへ保存します。

raw.png
RAW画像を読み込み、表示用に正規化した画像です。

demosaic.png
ブラックレベル補正、ホワイトバランス補正、デモザイク、正規化まで行った画像です。

gamma.png
正規化後のRGB画像にガンマ補正を適用した最終画像です。

main.pyで各処理をつなぐ

最後に、これまで説明した各関数をmain.pyで順番に呼び出します。
以下がmain.pyのソースコードです。

from pathlib import Path

from tools.raw_reader import load_raw_image
from tools.normalization import (normalize_raw, normalize_rgb)
from tools.print_col_median import print_col_median
from tools.black_level import apply_black_level_correction
from tools.white_balance_calibration import calibrate_white_balance
from tools.white_balance import apply_white_balance
from tools.demosaic import demosaic_bilinear
from tools.gamma import apply_gamma_correction
from tools.png_writer import save_png

PROJECT_DIR = Path(__file__).parent

# 実際に現像したい画像
RAW_FILE = PROJECT_DIR / "input" / "sample_raw.bin"

# ホワイトバランスキャリブレーション専用画像
CALIBRATION_FILE = PROJECT_DIR / "input" / "white_balance_calibration_raw.bin"

# 現像結果のPNG画像を保存するフォルダ
OUTPUT_DIR = PROJECT_DIR / "output"

def main() -> None:
    """シンプルなRAW現像パイプラインを実行する。"""

    # --------------------------------------------------
    # RAW画像読み込み
    # --------------------------------------------------
    
    image = load_raw_image(RAW_FILE)

    height, width = image.shape
    print(f"width={width}, height={height}")

    normalized_raw_image = normalize_raw(image)

    save_png(
        normalized_raw_image,
        OUTPUT_DIR / "raw.png"
    )    

    # --------------------------------------------------
    # ブラックレベル補正
    # --------------------------------------------------

    # 先頭100列の中央値を表示し、ブラックレベルの値を読み取る。
    print_col_median(image)

    # 現像対象画像をブラックレベル補正する。
    image = apply_black_level_correction(image)
    
    # --------------------------------------------------
    # ホワイトバランス
    # --------------------------------------------------

    calibration_image = load_raw_image(CALIBRATION_FILE)

    # キャリブレーション画像をブラックレベル補正する。
    calibration_image = apply_black_level_correction(calibration_image)

    # 無彩色ROIからR/Bゲインを求める。
    red_gain, blue_gain = calibrate_white_balance(
        calibration_image
    )
    
    # キャリブレーションで求めたWBゲインを適用する。
    # 画像全体はRGGBで始まる前提。
    image = apply_white_balance(
        image,
        red_gain,
        blue_gain,
    )

    # --------------------------------------------------
    # 線形補間デモザイク
    # --------------------------------------------------
    
    rgb_image = demosaic_bilinear(image)

    # --------------------------------------------------
    # RGB画像を0.0~1.0へ正規化
    # --------------------------------------------------
    
    normalized_rgb_image = normalize_rgb(
        rgb_image
    )

    save_png(
        normalized_rgb_image,
        OUTPUT_DIR / "demosaic.png",
    )
    
    # --------------------------------------------------
    # ガンマ補正
    # --------------------------------------------------
    
    gamma_rgb_image = apply_gamma_correction(
        normalized_rgb_image
    )

    save_png(
        gamma_rgb_image,
        OUTPUT_DIR / "gamma.png",
    )    


if __name__ == "__main__":
    main()

main.pyでは、toolsフォルダ内の各モジュールから必要な関数をインポートしています。

最初に、現像対象のRAWファイル、ホワイトバランスキャリブレーション用のRAWファイル、PNG画像の出力先を指定します。

その後、次の順番でRAW現像を行います。

① RAW画像の読み込み
② ブラックレベル補正
③ ホワイトバランス補正
④ デモザイク
⑤ 正規化
⑥ ガンマ補正

各処理を別のモジュールへ分割し、main.pyでは処理の順番だけを記述することで、RAW現像全体の流れを確認しやすい構成にしています。

おわりに

今回のツールを作成するにあたり、大泉宗徳氏の『PythonとColabでできる ゼロから作るRAW現像』を参考にさせていただきました。RAW現像の仕組みが分かりやすく解説されており、大きな助けとなりました。

そして、開発を一緒に進めてくれたOpenAIのCodex氏(笑)。コードの作成や修正、エラー原因の調査など、さまざまな場面で支えてもらいました。うん、君がいなかったらきっと僕は途中で挫折していたよ...

この場を借りて、両名に心より感謝申し上げます。

本)部下としてのAI 世界一流エンジニアの進化術_牛尾 剛_2026


ソフトウェアエンジニアの牛尾剛氏の本。夏休みに一気読みしました!面白かったー

 
著者のブログを実は10年位前から読ませてもらってるんですが、改めて尊敬できる方だなぁと思いました。
 
AI革命の中で奮闘する生き様、凄まじいですね。壁にぶち当たっては、改善点を洗い出して修正し、何度でも立ち上がってくる。自分もこうやって生きたい!
 
本書の話題は多岐にわたり、AI時代の働き方、勉強法、健康法、マインドセット等々、どれも読み応えがありました。
特にコーディングエージェントの使い方について、先進的なテクニックが紹介されている点が良かったです。
 
例えば以下。
・プロンプトを資産化して、開発を高速化する
・指示通りの結果になっているかAI自身にテストをさせてから出力させる
・指示と共に制約もAIに伝え誤作動を防ぐ、等
 
さすがはソフトウェアエンジニア。進んでるなぁ!
僕もこれからCodexを練習しようと思っているので、今のタイミングで読んどいて良かったです。
 
それにしても、もはやMicrosoftのエンジニアですら直接コーディングをすることは無くなったなんて、、、とんでもない時代ですね。
 
うーん、でも僕はある意味チャンスだと思ってますね〜。実際今Pythonを勉強してますが、AIの解説のおかげで爆速で理解が進むので、楽しいんですよね。
 
本書では全てが高速化された時代だからこそ「理解に時間をかけ、スキップしない習慣」が大事だと繰り返し強調されています。この点まじで共感しか無いです。